AI
Stratené v strede: modely najlepšie využijú začiatok a koniec textu
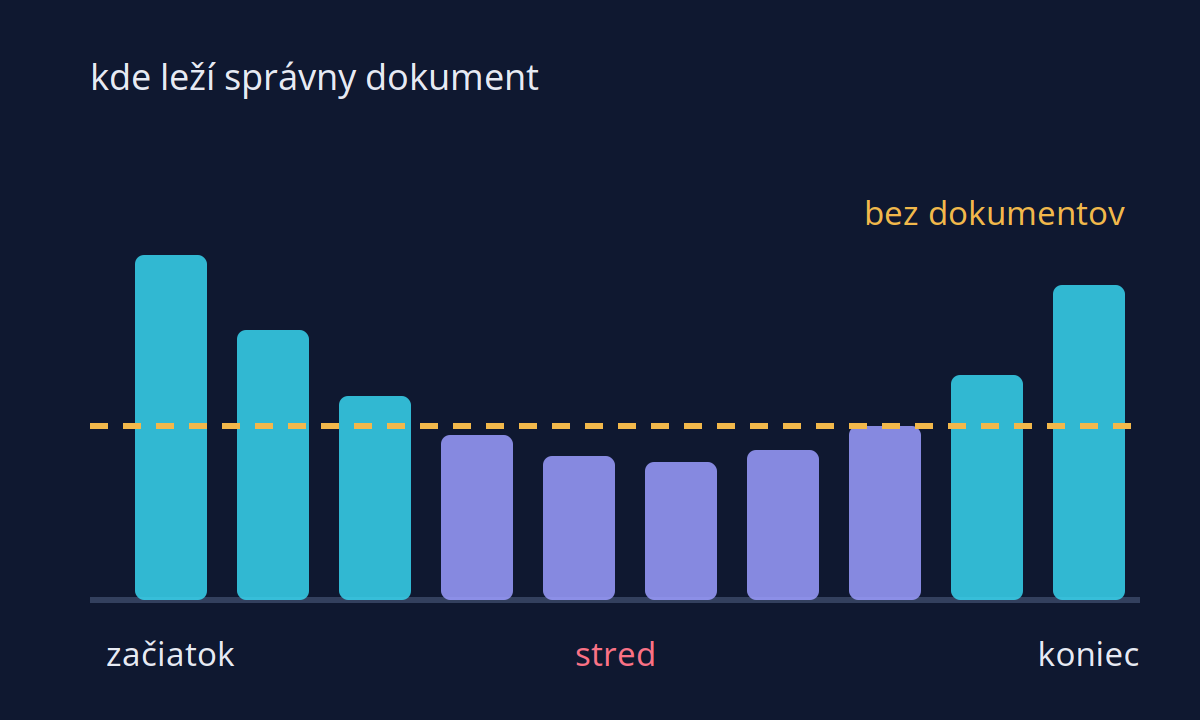
Keď bol jediný dokument s odpoveďou uprostred dvadsiatich, GPT-3.5-Turbo odpovedal správne menej často, než keď nedostal žiadny dokument a spoliehal sa len na vlastné znalosti.
Vedeli ste? · Agenti a prax · Liu, Liang a kol. · TACL 2023 (preprint júl 2023)
GPT-3.5-Turbo, Claude-1.3, MPT-30B-Instruct, LongChat-13B
Prvé a posledné v pamäti
Keď bol jediný dokument s odpoveďou uprostred dvadsiatich, GPT-3.5-Turbo odpovedal správne menej často, než keď nedostal žiadny dokument a spoliehal sa len na vlastné znalosti.
Keď človeku prečítaš dlhý zoznam, najlepšie si zapamätá prvé a posledné položky. Psychológovia to poznajú ako efekt sériovej pozície. Jazykové modely, ako sa ukázalo, majú niečo veľmi podobné.
Výskumníci dali modelom otázku a k nej 10, 20 alebo 30 dokumentov, z ktorých len jeden obsahoval odpoveď. Keď bol správny dokument na začiatku alebo na konci, model odpovedal dobre. Keď bol v strede, úspešnosť klesla, niekedy až pod úroveň, akú mal model úplne bez dokumentov.
Inými slovami: viac kontextu neznamená automaticky lepšie odpovede. Záleží aj na tom, kde v ňom leží to dôležité.
Dvadsať dokumentov, jedna odpoveď
GPT-3.5-Turbo odpovedal bez dokumentov, len z vlastných znalostí, správne v 56,1 % prípadov. S 20 dokumentmi, keď bol ten správny v strede, klesol na 53,8 až 55,4 %, pri 30 dokumentoch na 50,5 až 51,8 %. Verzie s dlhším kontextovým oknom (GPT-3.5-Turbo 16K, Claude-1.3 100K) neboli lepšie, pokiaľ sa vstup zmestil aj do kratšej verzie.
Nelson F. Liu, Kevin Lin, John Hewitt, Ashwin Paranjape, Michele Bevilacqua, Fabio Petroni a Percy Liang publikovali štúdiu „Lost in the Middle: How Language Models Use Long Contexts“ v časopise Transactions of the ACL. Testovali dve úlohy: odpovedanie na otázku z viacerých dokumentov a vyhľadanie hodnoty podľa kľúča v dlhom zozname.
Pri vyhľadávaní podľa kľúča (75, 140 a 300 dvojíc) zvládol Claude-1.3 takmer dokonale všetky dĺžky, ostatné modely zlyhávali hlavne v strede. Keď autori zopakovali otázku pred dátami aj za nimi, výsledky boli takmer dokonalé.
Dôležité na začiatok aj koniec
Predpoklad „čím väčšie kontextové okno, tým lepšie“ neplatí automaticky. Model síce text vidí celý, ale nevyužíva ho rovnomerne.
Prakticky pre každého, kto pracuje s AI asistentom: najdôležitejšie pokyny patria na začiatok zadania a to podstatné je dobré zopakovať na konci. Dlhé dokumenty sa oplatí rozdeliť alebo zhrnúť, namiesto toho, aby sa všetko vložilo naraz a odpoveď sa hľadala niekde v strede.
Zaujímavý je aj jednoduchý liek, ktorý autori našli: zopakovať otázku pred dátami aj za nimi. Pri dlhých zadaniach teda pomáha napísať, čo hľadáte, ešte pred vložením dlhého dokumentu, a zopakovať to na konci.
Zdroj: arXiv:2307.03172 · ar5iv: plný text
Originál: arXiv